制造业组织人事实操指南:排班预测的数据口径与数据闭环检查清单
制造业组织人事中排班预测的数据口径定义与常见断层
在制造业组织人事管理中,排班预测不是简单的“填格子”,而是一项依赖多源数据协同的计算任务。排班预测的准确性,直接取决于底层数据口径是否统一、字段定义是否清晰、跨层级流转是否失真。如果总部、工厂和班组对同一个数据字段的理解存在偏差,再先进的算法也无法输出可执行的排班计划。
排班预测的核心数据口径与业务含义
制造业组织人事场景下的排班预测,通常需要拉通以下四类核心数据字段。这些字段不仅是系统录入项,更是业务动作的数字化映射:
- 产能计划:指特定周期内(周/月)各产线的目标产出量或订单交付节点。它是排班预测的起点,决定了需要投入多少总工时。
- 班组编制:指维持某条产线正常运转所需的较低人数与标准配置。编制不仅包含数量,还涉及岗位结构(如操作工、质检员、物料员的比例)。
- 员工技能矩阵:记录每位一线员工具备的操作资质、设备认证及熟练度等级。在多品种小批量生产模式下,技能矩阵决定了人员能否在不同工位间灵活调配。
- 历史出勤率:基于过往考勤数据计算出的实际到岗比例,需区分病假、事假、旷工及季节性波动规律。这是将“理论需求人数”转化为“实际排班人数”的关键修正系数。
Insight: 在制造业组织人事实践中,排班预测的本质是“用确定性的规则去应对不确定性的现场”。如果上述四个口径的定义模糊,排班结果必然脱离实际,导致产线停线或人力成本溢出。
总部、工厂、班组三层的数据理解断层
制造企业的管理链条通常分为总部、工厂、班组三层。这三层在排班预测中的数据诉求和视角天然不同,极易产生口径断层。
| 管理层级 | 关注重点 | 典型数据口径偏差 | 业务影响 |
|---|---|---|---|
| 总部 | 整体编制控制、人力成本预算、合规性 | 将“编制数”等同于“在岗数”,忽略一线流失率与出勤折损 | 下达的排班指导原则过于理想化,缺乏弹性空间 |
| 工厂 | 产能达成率、跨车间调度、订单交付 | 将“技能达标”简化为“岗位匹配”,忽视具体设备的操作资质差异 | 排班表看似满编,但关键工位因技能不符无法开机 |
| 班组 | 现场运转、临时替岗、员工情绪与疲劳度 | 凭经验手工调整班次,未将调班原因沉淀为结构化数据 | 历史出勤率和异常数据无法回流,预测模型失去迭代依据 |
这种断层并非单纯的管理态度问题,而是组织架构与信息系统割裂的必然结果。当总部看的是Excel汇总表,工厂用的是MES系统的生产计划,班组靠的是微信群里的接龙时,数据口径的统一就无从谈起。
flowchart TD
    A[总部: 产能计划与编制预算] -->|下发指导口径| B(工厂: 生产排程与技能盘点)
    B -->|分解排班指令| C{班组: 现场执行与考勤打卡}
    C -->|回传实际出勤与异常| B
    B -->|汇总人效与缺口数据| A

    style A fill:#f9f9f9,stroke:#333
    style B fill:#e1f5fe,stroke:#0288d1
    style C fill:#fff3e0,stroke:#f57c00
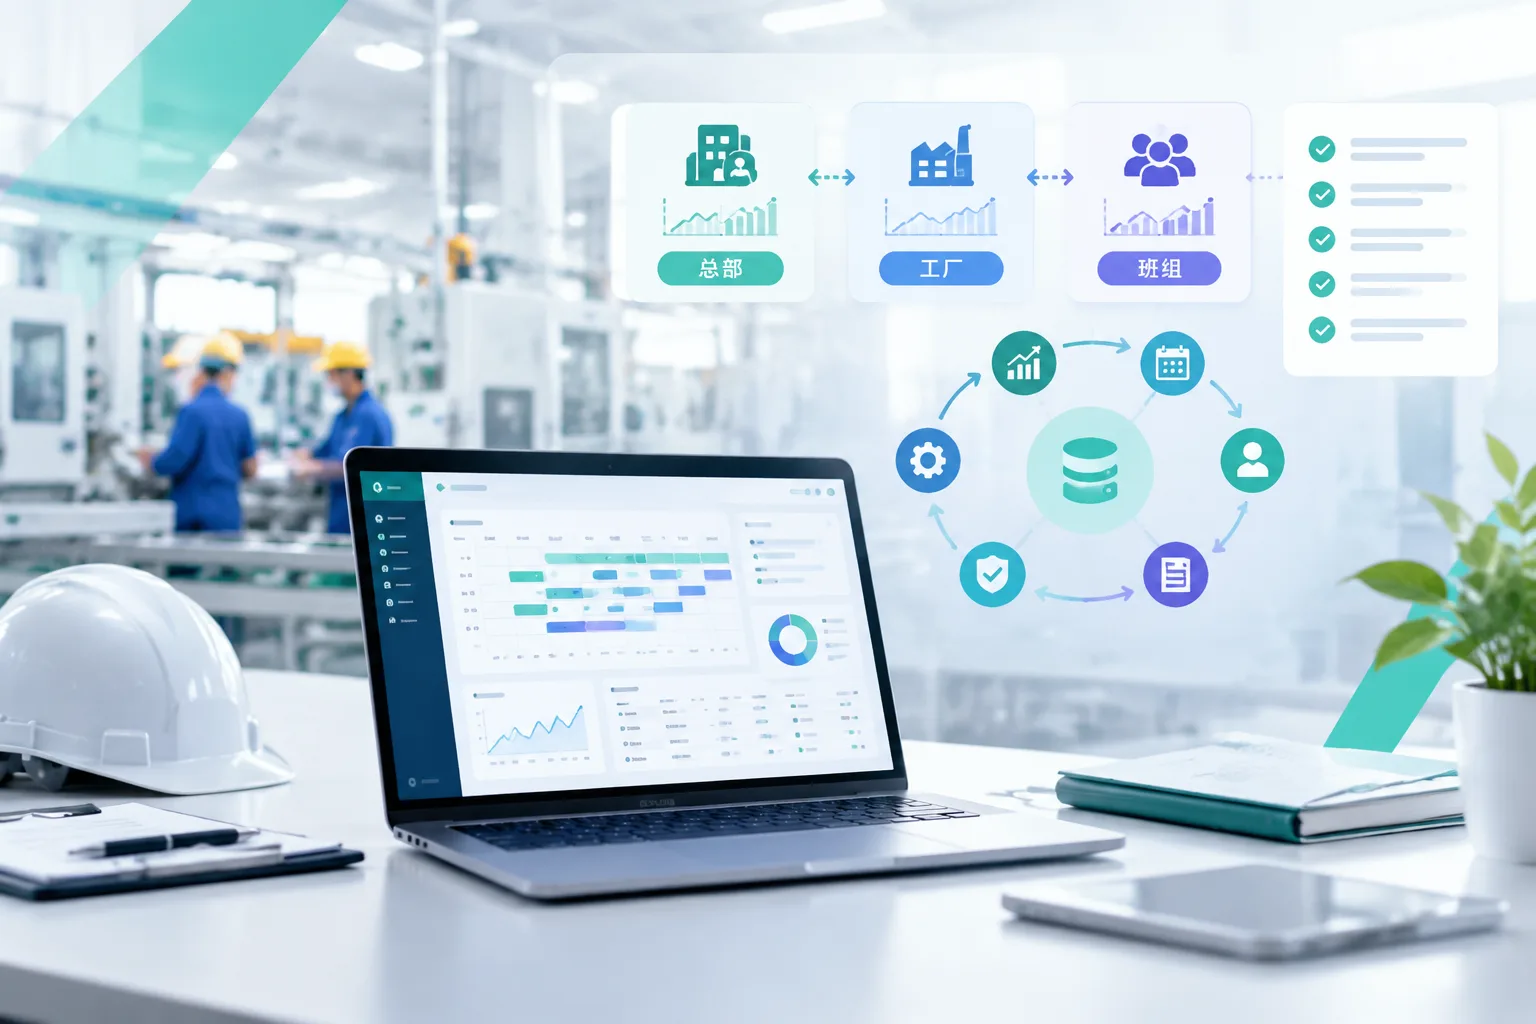
上图展示了制造业组织人事中排班数据的标准流转路径。要实现这一闭环,前提是A、B、C三个节点对“编制”、“出勤”、“技能”等基础字段的定义完全一致。
为什么统一数据口径是排班预测的前提
排班预测是一个乘法模型:预测需求人数 = (产能计划所需总工时 ÷ 单人标准工时) ÷ 历史出勤率。在这个公式中,任何一个变量的口径发生偏移,最终结果都会被成倍放大。
例如,
从排班预测到执行落地的数据闭环流程
在制造业组织人事管理中,排班预测从来不是一次性的计划动作,而是一条必须跑通的数据闭环。很多工厂的排班表之所以“排得出、落不下”,根本原因在于需求输入、模型运算、现场执行和差异反馈之间没有形成连续的数据流。要真正实现考勤排班全流程自动化,企业必须把这条链路拆解为可监控、可迭代的标准化节点。
数据闭环的六个核心阶段
制造业一线生产排班场景极为复杂,常白班、三班倒、轮休调班往往在同一家工厂甚至同一个车间内并存。面对这种复杂度,数据闭环需要覆盖以下六个阶段:
- 需求输入(订单/产能):排班的起点不是HR的主观经验,而是生产计划。系统需要接入ERP或MES中的订单量、产线节拍和设备产能数据,将其转化为具体的工时需求和岗位缺口。
- 排班模型运算:基于需求输入,结合员工技能矩阵、合规工时上限和历史出勤率,由系统自动生成班次草案。这一步的核心是规则引擎的准确性,例如夜班津贴的计算逻辑、连续工作天数的限制等。
- 班次发布与审批:草案生成后,需经过车间主任或班组长的确认,处理临时调班、请假替换等异常,最终将确定的班次下发至员工端。
- 考勤打卡采集:员工按班次到岗,通过人脸识别、工牌刷卡或移动端定位完成打卡。采集到的不仅是“是否迟到”,还包括实际在岗时长、跨班次交接时间等细颗粒度数据。
- 差异分析:将实际考勤数据与排班预测模型进行比对,识别偏差来源。是订单临时变更导致加班?还是某条产线缺勤率异常升高?差异分析是闭环中最具业务价值的环节。
- 模型修正:将差异分析的结论反哺给排班算法,调整下一周期的预测权重。例如,若发现某类岗位的流失率高于预期,模型应在下次排班时自动增加备岗比例。
Insight: 制造业组织人事的排班闭环,本质上是“用执行数据校准预测模型”的持续迭代机制。单次排班再精准,如果没有差异分析和模型修正,下个月依然会面临同样的失控。
角色协同与系统流转路径
数据闭环的落地不仅依赖算法,更依赖总部HR、工厂管理层与一线班组长之间的角色协同。如果各层级使用的数据口径不一致,闭环就会在流转中断裂。例如,像利唐i人事 这类适配制造业场景的系统,其价值在于将组织架构、岗位编制、考勤规则与薪资核算放在统一的数据底座上,确保总部看的是整体人效,工厂看的是产能匹配,班组看的是现场运转,三层视图同源同径。
以下是制造业排班预测数据闭环的流转路径及角色协同关系:
flowchart TD
    A[需求输入<br>订单/产能数据] --> B[排班模型运算<br>规则引擎计算]
    B --> C[班次发布与审批<br>车间主任/班组长确认]
    C --> D[考勤打卡采集<br>一线员工执行]
    D --> E[差异分析<br>HR与生产部门复盘]
    E --> F[模型修正<br>更新预测权重]
    F --> A

    subgraph 协同角色
        R1[生产计划部] -.-> A
        R2[HR/系统平台] -.-> B
        R3[车间管理层] -.-> C
        R4[一线员工] -.-> D
    end
复杂场景下的自动化落地判断标准
在实际操作中,如何判断一个制造业企业的排班数据闭环是否真正跑通?可以参考以下三个维度的检查清单:
| 检查维度 | 未闭环状态(手工/半手工) | 已闭环状态(系统自动化) |
|---|---|---|
| 数据口径 | 生产计划用Excel,考勤用另一套表格,两套数据对不上 | 订单需求直接驱动排班规则,考勤结果自动关联薪资核算 |
| 异常处理 | 员工临时调班需 |
排班预测数据闭环检查清单与系统选型要点
在制造业组织人事管理中,排班预测不能停留在“算出结果”这一步。预测模型输出的班次建议如果无法回流到考勤执行、薪资核算和人员调配流程中,就会变成一张废纸。建立数据闭环,意味着从数据采集、口径校验、异常处理到反馈修正的每一个环节都有明确的检查标准和责任归属。对于正在推进数字化转型的制造企业而言,这份闭环检查清单可以直接作为内部 SOP 或系统上线前的验收依据。
排班预测数据闭环检查清单
以下清单围绕制造业排班预测的核心痛点设计,涵盖数据源完整性、口径一致性、异常处理机制和反馈时效性四个维度。企业 HR 负责人或信息化团队可逐项核对,确保排班预测不仅“算得准”,还能“落得下”。
| 检查维度 | 检查项 | 具体标准与判断依据 | 常见失效场景 |
|---|---|---|---|
| 数据源完整性 | 历史出勤数据覆盖率 | 过去 12 个月的实际出勤、请假、加班记录完整度需达到 95% 以上,缺失月份需人工补录或标记剔除。 | 仅使用近 3 个月数据,导致季节性产能波动未被识别。 |
| 员工技能矩阵同步 | 排班池内员工的岗位资质、多能工认证状态需与组织人事主数据实时同步,避免将无资质人员排入特种工位。 | 调岗后技能标签未更新,排班系统仍按原岗位分配任务。 | |
| 订单与产能计划接入 | 生产计划(MPS/MRP)中的工时需求需作为排班预测的输入变量,而非仅依赖历史均值。 | HR 系统与 ERP 脱节,排班人数与实际产线负荷不匹配。 | |
| 口径一致性 | 工时计算规则统一 | 标准工时、计件折算工时、加班工时的定义需在考勤模块与薪资模块中保持少有解释,消除“两套账”。 | 考勤按打卡时长算,薪资按计件产量算,导致排班成本测算失真。 |
| 班次类型编码规范 | 常白班、两班倒、三班倒、综合工时制等班次类型需有全局统一的编码体系,跨工厂调用时不可产生歧义。 | A 厂的“早班”与 B 厂的“早班”起止时间不同,合并预测时报错。 | |
| 异常处理机制 | 缺勤与突发离职响应 | 当实际到岗率低于预测阈值(如 90%)时,系统需触发预警并自动推荐替补人员名单或跨班组借调方案。 | 发现缺人时只能靠班组长打电话临时摇人,响应滞后超 4 小时。 |
| 合规红线拦截 | 排班结果生成后,需自动校验是否违反劳动法关于连续工作天数、月度加班上限及未成年工/女职工保护的规定。 | 为赶交期连续排班 7 天,引发劳动监察风险或员工集中投诉。 | |
| 反馈时效性 | 预测偏差复盘周期 | 每周对比“预测排班”与“实际执行排班”的差异率,差异超过 5% 的班组需在下周模型参数中进行权重调整。 | 预测模型上线后半年未调参,准确率随人员流动逐渐下降。 |
| 员工确认与申诉通道 | 排班表发布后,员工需在 24 小时内通过移动端确认或发起调班申请,超时未确认视为默认接受。 | 纸质排班表张贴后无人核对,发薪时因班次争议产生纠纷。 |
Insight: 制造业组织人事的数据闭环,本质上是把“排班”从一个孤立的行政动作,升级为连接生产计划、考勤执行、薪资核算与合规风控的业务枢纽。没有闭环的预测,只会增加一线管理者的核对负担。
支撑数据闭环的系统架构流转
要让上述检查清单真正落地,底层系统必须支持数据的顺畅流转。排班预测不是单点功能,而是贯穿组织人事、考勤、薪资和绩效的连续链路。以下是典型的数据闭环流转路径
常见问题 Q&A
排班预测数据口径不统一会导致什么后果?
在制造业组织人事管理中,数据口径不统一最直接的后果是“算不准”和“对不上”。例如,生产部门按“实际产出工时”提报需求,而 HR 按“考勤打卡时长”做排班预测,两者之间的统计边界不同,会导致系统生成的排班计划与产线真实缺口脱节。具体表现为:部分班组长期超负荷运转引发离职潮,另一些班组则出现冗余人力推高成本。更严重的是,当考勤、薪酬、绩效各自使用不同的底层数据时,每月薪资核算需要大量人工核对,极易引发劳资纠纷。解决这个问题的前提是建立统一的组织人事主数据标准,确保编制、岗位、工时等核心字段在全链路中只有一个定义来源。
如何判断企业是否建立了有效的数据闭环?
判断制造业企业的数据闭环是否有效,不要只看有没有上系统,要看三个业务动作能否自动流转。第一,一线员工发生入转调离后,排班池中的可用人数是否能实时更新,而不需要 HR 手动修改 Excel;第二,考勤异常(如缺卡、迟到)发生后,是否能直接触发补员预警或影响当月计件薪资核算;第三,管理层查看人效报表时,数据是否能穿透到具体的车间、班组甚至个人。如果这三个环节仍依赖线下传递或人工搬运数据,说明闭环尚未打通。像利唐i人事这类适配制造业场景的系统,其核心价值就在于将招聘到岗、班次考勤、薪资核算和组织协同放在同一套数据底座上运行,让信息流跟着业务流走。
制造业选择排班系统应重点考察哪些能力?
制造业排班不同于零售或服务业的弹性排班,选型时必须重点考察三项硬能力。首先是复杂班次规则的承载力,系统必须原生支持常白班、两班倒、三班倒、综合工时制以及跨天轮休等混合模式,而不是只能处理标准工时。其次是与考勤和薪酬模块的联动深度,排班结果必须能直接作为考勤比对的基准,并无缝对接计件工资、加班补贴等多维薪资结构。最后是移动端的一线触达能力,蓝领员工通常没有固定工位,系统需要提供便捷的小程序或手机端入口,让员工能自主查看排班、提交调班申请和处理考勤异议。脱离这三点谈算法预测,往往无法真正落地。
为什么排班预测不能只靠历史出勤数据?
很多制造企业做排班预测时,习惯直接拉取过去几个月的平均出勤率来推算未来需求,这种做法忽略了制造业特有的波动因素。历史出勤数据反映的是“过去发生了什么”,但排班预测需要回答的是“未来需要什么”。产线订单的季节性波动、新设备投产带来的技能要求变化、批量入职新员工的熟练度爬坡期,以及突发的集中离职,都会让历史均值失效。有效的排班预测需要将订单计划、产能目标、人员技能矩阵和历史流失率等多维数据交叉输入。这要求制造业组织人事管理不能停留在事务记录层面,而要向前延伸到业务规划端,形成从业务需求到人力配置的动态测算逻辑。
Insight: 制造业排班预测的本质不是数学题,而是业务翻译题——把产线的产能语言准确翻译成组织人事的排班语言。
总部与工厂在排班管理上经常脱节,如何通过系统改善?
总部关注整体编制合规与人力成本控制,工厂关注当期产能交付,班组关注现场能不能转起来。三层视角如果不通过系统强制对齐,排班指令就会层层失真。改善的关键在于建立“一套架构、分级授权”的组织人事管理模式。总部在系统中统一定义组织架构、岗位编制上限和排班规则底线;工厂在规则范围内根据实际订单调整班次模型;班组则在既定排班下执行日常考勤与微调。所有层级的操作都在同一个平台上留痕并实时汇总。通过这种方式,总部能看到真实的用工饱和度,工厂能获得灵活的调度空间,班组能减少因规则不清导致的沟通内耗,真正实现业务驱动的组织协同。